SseEmitter를 반환하고 나서 시작된 일들
SSE는 컨트롤러에서 SseEmitter를 반환하면 화면이 뜹니다. 그런데 운영에 올리면 부하, 스레드 격리, 전송 순서, 종료, 세션 만료, 재연결, 권한 회수가 차례로 문제가 됩니다. 한 대시보드에서 실제로 부딪힌 순서대로 정리했습니다.
들어가며
이 글은 1편에서 폴링·롱폴링·SSE·WebSocket 에 대해서 정리한 내용을 기반으로, 비슷한 성격의 2개의 대시보드 페이지(처리 파이프라인, 요약)를 왜 SSE와 폴링으로 나누어 구현했는지와 당시 고민거리들과 결정 배경에 대해서 적어보았습니다.
글의 순서는 먼저 두 화면이 왜 갈렸는지를 자세히 짚고, 그다음 SSE로 간 화면을 운영에 올리면서 발생한 고민거리들에 대해서 순서대로 다룹니다. SSE는 컨트롤러에서 SseEmitter를 반환하는 것만으로 화면이 뜹니다. 문제는 그 코드가 "동작하는 코드"일 뿐 "운영에 올릴 수 있는 코드"는 아니라는 데서 시작됐습니다.
두 화면은 왜 갈렸나
사내에서 운영하는 제품의 관리 콘솔 이야기입니다. 화면 이름과 구조는 일반화해서 적었습니다. 한 대시보드 안에 실시간 화면이 둘 있었습니다. 하나는 데이터가 처리 파이프라인을 통과하는 모습을 초 단위로 보여 주는 처리 파이프라인 화면(신규), 다른 하나는 통계 위젯 열한 개를 모아 놓은 요약 대시보드 화면(개선)입니다.
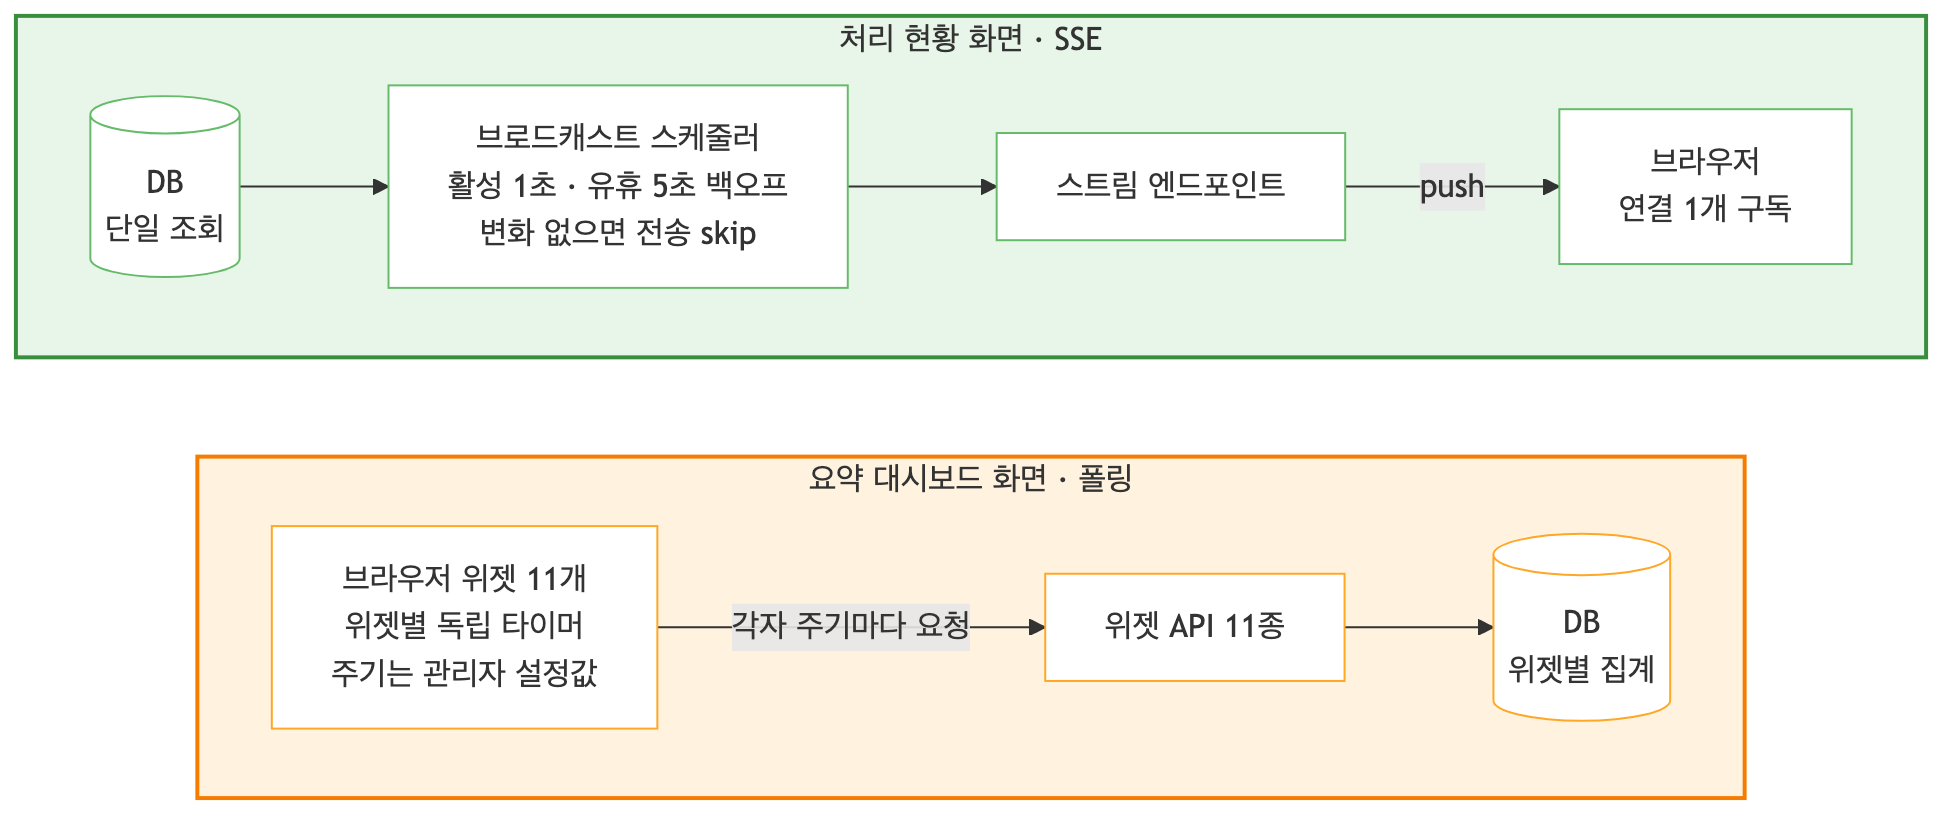
처리 파이프라인 화면에 SSE를 쓴 이유
먼저 이 화면이 무엇인지 그려 두겠습니다. 여러 처리 작업이 동시에 흘러가는 모습을 실시간으로 보여 주는 화면입니다. 작업 하나가 가로 레인 하나가 되고, 각 레인의 데이터가 수집 → 분석 → 검출 → 저장이라는 네 단계를 지나갑니다. 처리량이 늘어난 만큼 단계 사이를 작은 점들이 왼쪽에서 오른쪽으로 흘러가고, 레인마다 진행률 막대와 경과 시간, 초당 처리 건수가 붙습니다. 화면 아래에는 전체 작업 수와 누적 처리 건수 같은 요약이 놓입니다. 클라이언트는 매 갱신마다 직전 스냅샷과의 차이를 계산해 그 차이만큼 점을 흘려보냅니다. 이 "차이로 점을 만든다"는 구조가 뒤의 순서 문제와 이어집니다.
서버에서 조회하는 데이터는 이 파이프라인 상태 하나뿐이고, 화면 전체가 그 하나를 바라봅니다. SSE로 간 이유는 세 가지였습니다.
주기가 짧아서, 사용자가 늘면 그대로 부담이 됩니다. 폴링으로 만들면 초 단위로 요청을 보내야 하고, 요청 수는 동시 사용자 수에 그대로 비례합니다. 1편에서 봤듯 1초 주기는 폴링에서 가장 비싼 구간입니다. SSE로 만들면 사용자가 늘어도 브로드캐스트 한 번에 조회도 한 번이고, 늘어나는 건 유지할 커넥션 수뿐입니다.
데이터 소스가 하나입니다. 스트림 하나를 열면 화면에 필요한 모든 값이 그 위로 흐르므로 SSE로 묶는 비용이 작았습니다. 게다가 화면이 값 하나만 바라보니, 그 조회가 막히면 폴링이든 SSE든 똑같이 멈춥니다. 방식을 바꿔서 더 잃을 것도 없었습니다.
한산할 때는 아무것도 보내지 않습니다. 파이프라인이 종일 바쁘지 않고 언제 바빠질지도 예측할 수 없습니다. 폴링이라면 아무 일이 없어도 화면을 켜 둔 내내 요청이 나가지만, SSE에서는 서버가 상황을 보고 조절합니다. 구독자가 없으면 조회 자체를 건너뛰고, 직전과 데이터가 같으면 전송을 생략하고, 빈 결과가 이어지면 주기를 1초에서 5초로 늦춥니다.
요약 대시보드 화면에 폴링을 쓴 이유
같은 대시보드의 다른 탭인데 판단이 반대로 갔습니다. 출발점부터 달랐습니다. 이쪽은 이미 있는 화면이었고 원래 접속 시 한 번만 조회했는데, 이번에 주기 갱신을 붙이는 작업이었습니다.
갱신 주기의 폭이 너무 넓습니다. 관리자가 위젯별로 주기를 초·분 단위로 직접 정하고 상한이 없습니다. 몇 초마다 봐야 하는 위젯이 있는가 하면 몇 시간에 한 번이면 충분한 위젯도 있습니다. 한 시간에 한 번 바뀌는 값 때문에 커넥션을 한 시간 열어 두는 건 앞뒤가 맞지 않습니다.
게다가 그 주기를 관리자가 런타임에 바꿉니다. 폴링에서는 이게 공짜입니다. 클라이언트가 설정값을 읽어 위젯별 타이머를 걸고, 설정이 바뀌면 타이머를 다시 겁니다. SSE로 만들면 이 주기가 서버 상태가 됩니다. 위젯별 스케줄 열한 개를 서버가 들고 돌리고, 값이 바뀔 때마다 런타임에 다시 등록해야 합니다. 그 비용은 파이프라인 쪽에서 이미 치러 봤습니다. 동적 주기가 하나뿐인데도 @Scheduled로는 표현할 수 없어 Trigger와 전용 스케줄러를 직접 만들어야 했습니다.
// 활성 1초 / 유휴 5초. 주기가 런타임에 바뀌므로 고정 주기 애너테이션을 쓸 수 없습니다
Trigger broadcastTrigger = ctx -> {
    Instant base = ctx.lastCompletion() != null ? ctx.lastCompletion() : ctx.getClock().instant();
    return base.plusMillis(broadcastService.currentIntervalMs());
};
scheduler.schedule(broadcastService::broadcast, broadcastTrigger);
데이터가 하나로 묶이지 않고, 장애 파급도 다릅니다. 위젯마다 집계 쿼리가 다르고 이미 각자 REST 엔드포인트에 물려 있습니다. 스트림 하나에 담으려면 매 주기 열한 개 쿼리를 전부 돌려 합치고 구조를 통째로 다시 설계해야 합니다. 폴링은 위젯 하나가 자기 주기에 자기 엔드포인트를 부르고 자기 영역만 다시 그립니다. 하나가 느려지거나 실패해도 나머지 열 개는 계속 갱신됩니다. 스트림 하나로 묶었다면 그 연결이 끊기는 순간 화면 전체가 멈췄을 겁니다.
애초에 트래픽이 적습니다. 소수의 담당자만 접속하는 콘솔이라 동시 사용자가 많아야 몇 명입니다. 폴링의 가장 큰 약점인 요청 수 폭증이 이 환경에서는 생기지 않습니다. 트래픽이 많았다면 판단이 달라졌을 수도 있습니다.
정리: 두 화면을 가른 것들
| 축 | 처리 파이프라인 화면 | 요약 대시보드 |
|---|---|---|
| 출발점 | 신규 페이지, 처음부터 방식을 선택 | 1회 조회하던 화면에 주기 갱신을 추가 |
| 갱신 주기 | 1~5초 고정 구간 | 몇 초 ~ 몇 시간, 관리자가 런타임 조정 |
| 데이터 | 단일 소스, 조회 하나가 화면 전체 | 위젯 11종, 서로 다른 집계 |
| 리스크 | 단일 소스라 방식을 바꿔도 더 잃을 게 없음 | 스트림 1개 장애 = 위젯 11개 동시 정지 |
| 처리량 | 사용자가 늘어도 조회는 브로드캐스트 1회 | 동시 사용자가 소수라 요청 수 폭증이 없음 |
| 만드는 비용 | 소스가 하나라 SSE로 묶기 쉬움 | 조회 11개 + 동적 스케줄 11개를 서버로 올려야 함 |
이렇게 처리 파이프라인 화면은 SSE로 갔습니다. 화면을 띄우는 것 자체는 쉬웠습니다. 어려운 건 그다음이었습니다.
동작하는 코드는 30줄이면 된다
가장 단순한 SSE 구현은 이 정도입니다.
@GetMapping(value = "/api/pipeline/subscribe", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public SseEmitter subscribe() {
    SseEmitter emitter = new SseEmitter(60L * 60 * 1000);   // 타임아웃 1시간
    emitters.add(emitter);
    emitter.onCompletion(() -> emitters.remove(emitter));
    emitter.onTimeout(() -> emitters.remove(emitter));
    return emitter;
}

// 주기적으로 모든 구독자에게 밀어 보냅니다
public void broadcast() {
    String json = toJson(pipelineService.snapshot());
    for (SseEmitter emitter : emitters) {
        try {
            emitter.send(SseEmitter.event().data(json));
        } catch (IOException e) {
            emitters.remove(emitter);
        }
    }
}
이걸로 화면은 뜹니다. 브라우저의 EventSource가 /api/pipeline/subscribe에 붙고, 서버는 주기마다 스냅샷을 밀어 보냅니다. 데모라면 여기서 끝입니다.
문제는 이 코드에 없는 것들입니다. 아무도 안 보는데도 계속 조회하고, 느린 클라이언트 하나가 전체를 세우고, 병렬 전송이 순서를 뒤집고, 종료가 전송에 막히고, 사용자가 보고 있는데 세션이 만료되고, 서버가 잠깐 죽으면 전 클라이언트가 동시에 재연결로 몰려옵니다. 하나씩 부딪힌 순서대로 풀어 보겠습니다.
1. 아무도 안 보는데 DB를 계속 조회한다
위 broadcast()는 구독자가 있든 없든 매 주기 snapshot()을 호출합니다. 화면을 아무도 안 보고 있어도 서버는 1초마다 DB를 두드립니다. 밤새 한 명도 접속하지 않아도 마찬가지입니다.
첫 번째 마개는 구독자 수 검사입니다. 레지스트리가 비어 있으면 조회 이전에 즉시 빠집니다. 브로드캐스트뿐 아니라 하트비트, 권한 갱신 같은 주기 작업 모두 같은 가드를 답니다.
두 번째는 중복 전송 제거(dedup)입니다. 직전에 보낸 JSON 문자열을 들고 있다가, 새로 조회한 결과가 같으면 전송을 건너뜁니다. 전송이 별도 스레드에서 일어나므로 값의 가시성을 위해 원자적 참조에 담습니다.
private final AtomicReference<String> lastJson = new AtomicReference<>("");

public void broadcast() {
    if (emitters.isEmpty()) return;              // 구독자 0명이면 조회 자체를 안 한다
    String json = toJson(pipelineService.snapshot());
    if (json.equals(lastJson.get())) return;     // 직전과 같으면 전송 생략
    lastJson.set(json);
    push(json);
}
세 번째는 유휴 백오프입니다. 빈 결과가 연속으로 몇 번(기본 3회) 나오면 브로드캐스트 주기를 활성 1초에서 유휴 5초로 늦추고, 데이터가 다시 생기면 즉시 1초로 복귀합니다. 앞서 본 Trigger가 이 동적 주기를 표현하는 장치입니다.
여기에 이 시스템 특유의 조건이 하나 더 붙었습니다. 사용자 권한에 따라 보이는 자원이 달라서, 같은 스냅샷이라도 구독자마다 필터링이 필요했습니다. 매번 구독자 수만큼 직렬화하면 낭비이므로, 같은 권한 집합을 가진 구독자끼리 직렬화 결과를 재사용했습니다.
// 허용 자원 집합 → 필터링된 JSON. 같은 권한이면 재사용
Map<Set<Integer>, String> serializedByPermission = new HashMap<>();
한 가지 함정이 있습니다. 캐시 키가 Set이므로 불변이어야 합니다. Set.copyOf로 감싸고, 권한이 바뀌면 Set 내용을 고치는 게 아니라 통째로 교체합니다. 가변으로 두면 키의 해시가 깨져 캐시가 엉킵니다. 그리고 필터링 직렬화가 실패하면 전체 데이터가 아니라 빈 배열을 반환합니다. 실패 시 권한 없는 자원이 노출되지 않게 하는 안전한 기본값입니다.
2. 느린 클라이언트 하나가 전체를 멈춘다
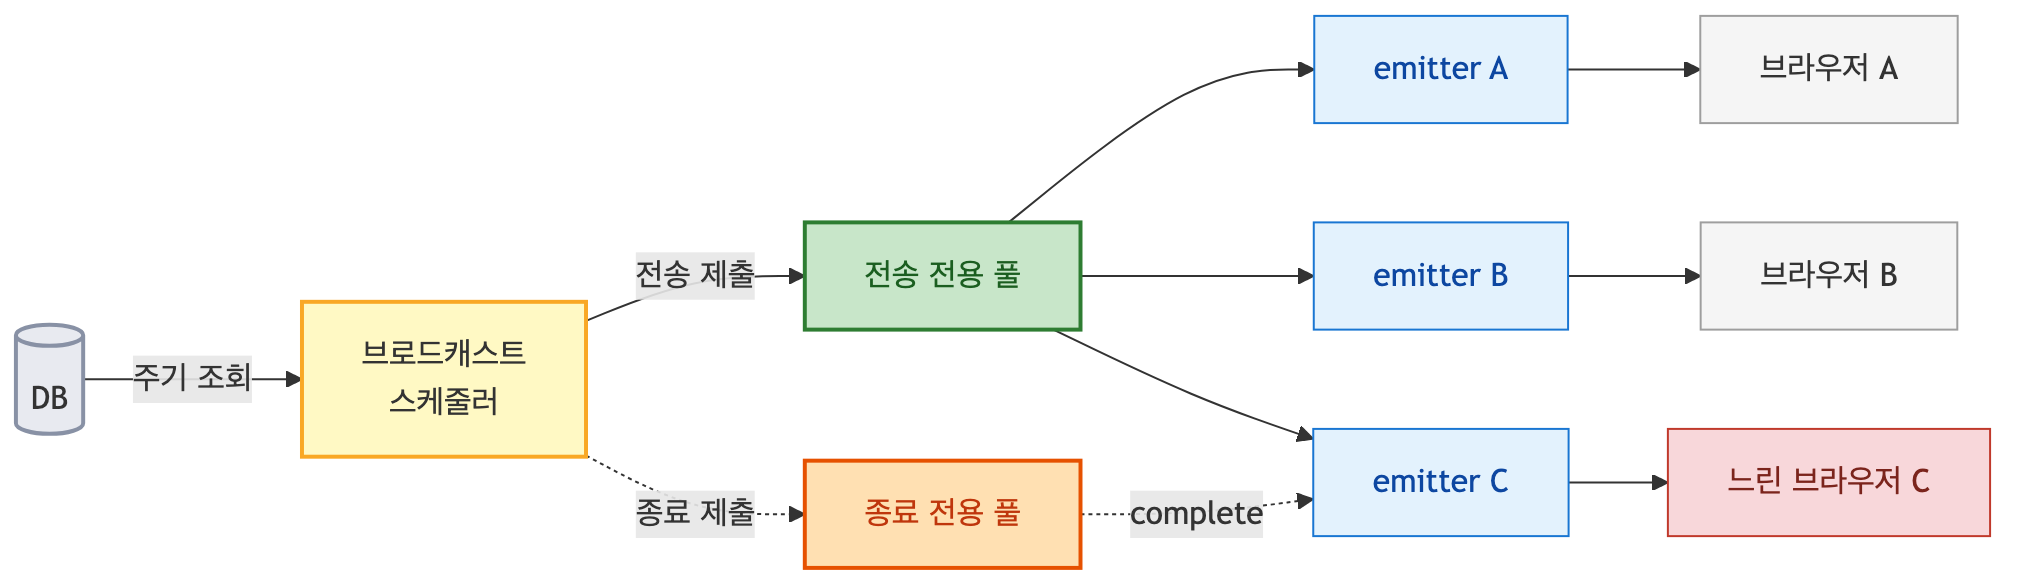
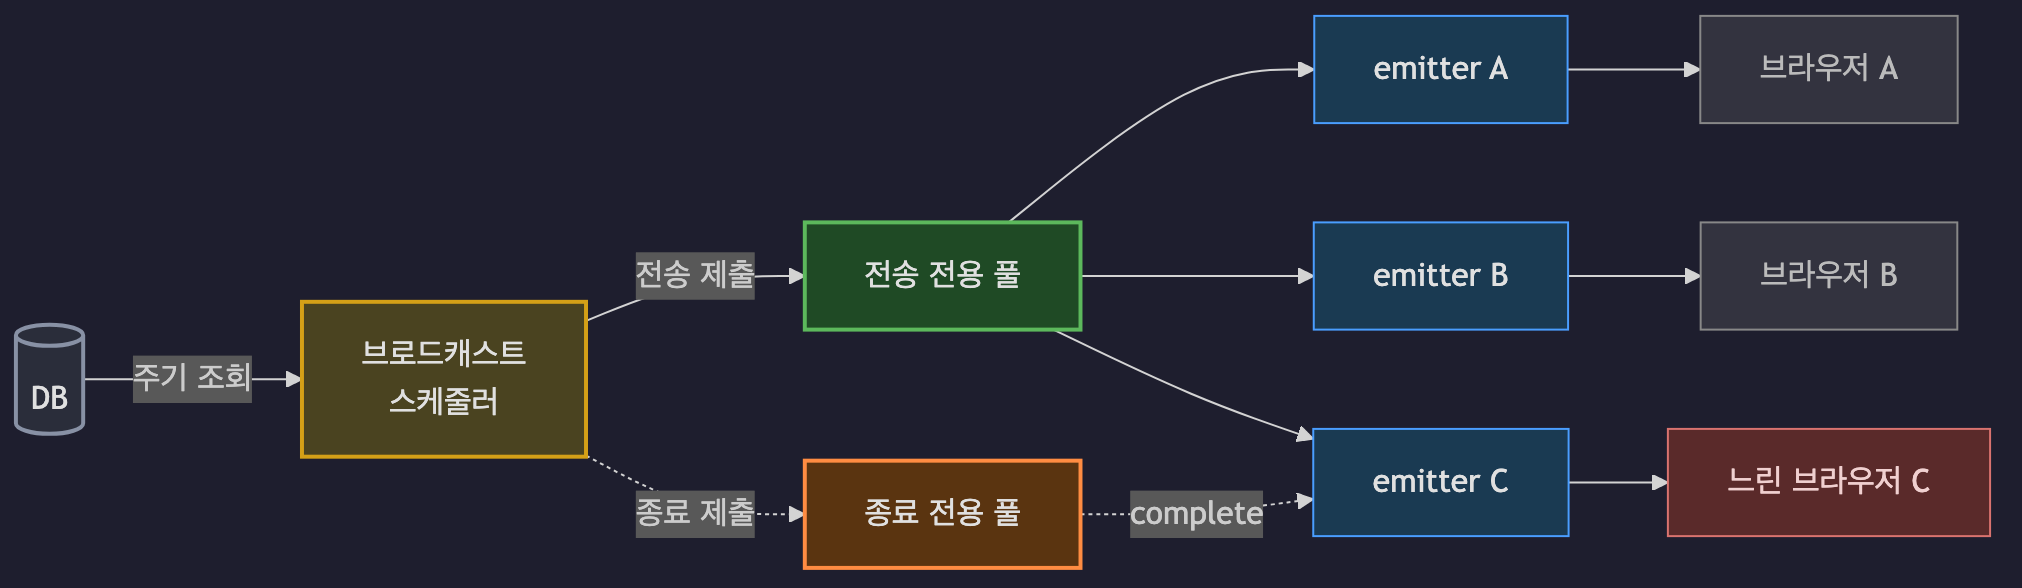
emitter.send()는 블로킹 쓰기입니다. 수신이 느린 클라이언트에게 쓰는 동안 호출 스레드가 그만큼 묶입니다. 그런데 위 broadcast()는 브로드캐스트 스케줄러 스레드에서 구독자를 순회하며 직접 send()합니다. 느린 클라이언트 한 명이 지하철에서 화면을 켜 두면, 그 사람에게 쓰는 동안 나머지 구독자 전원의 전송이 밀립니다.
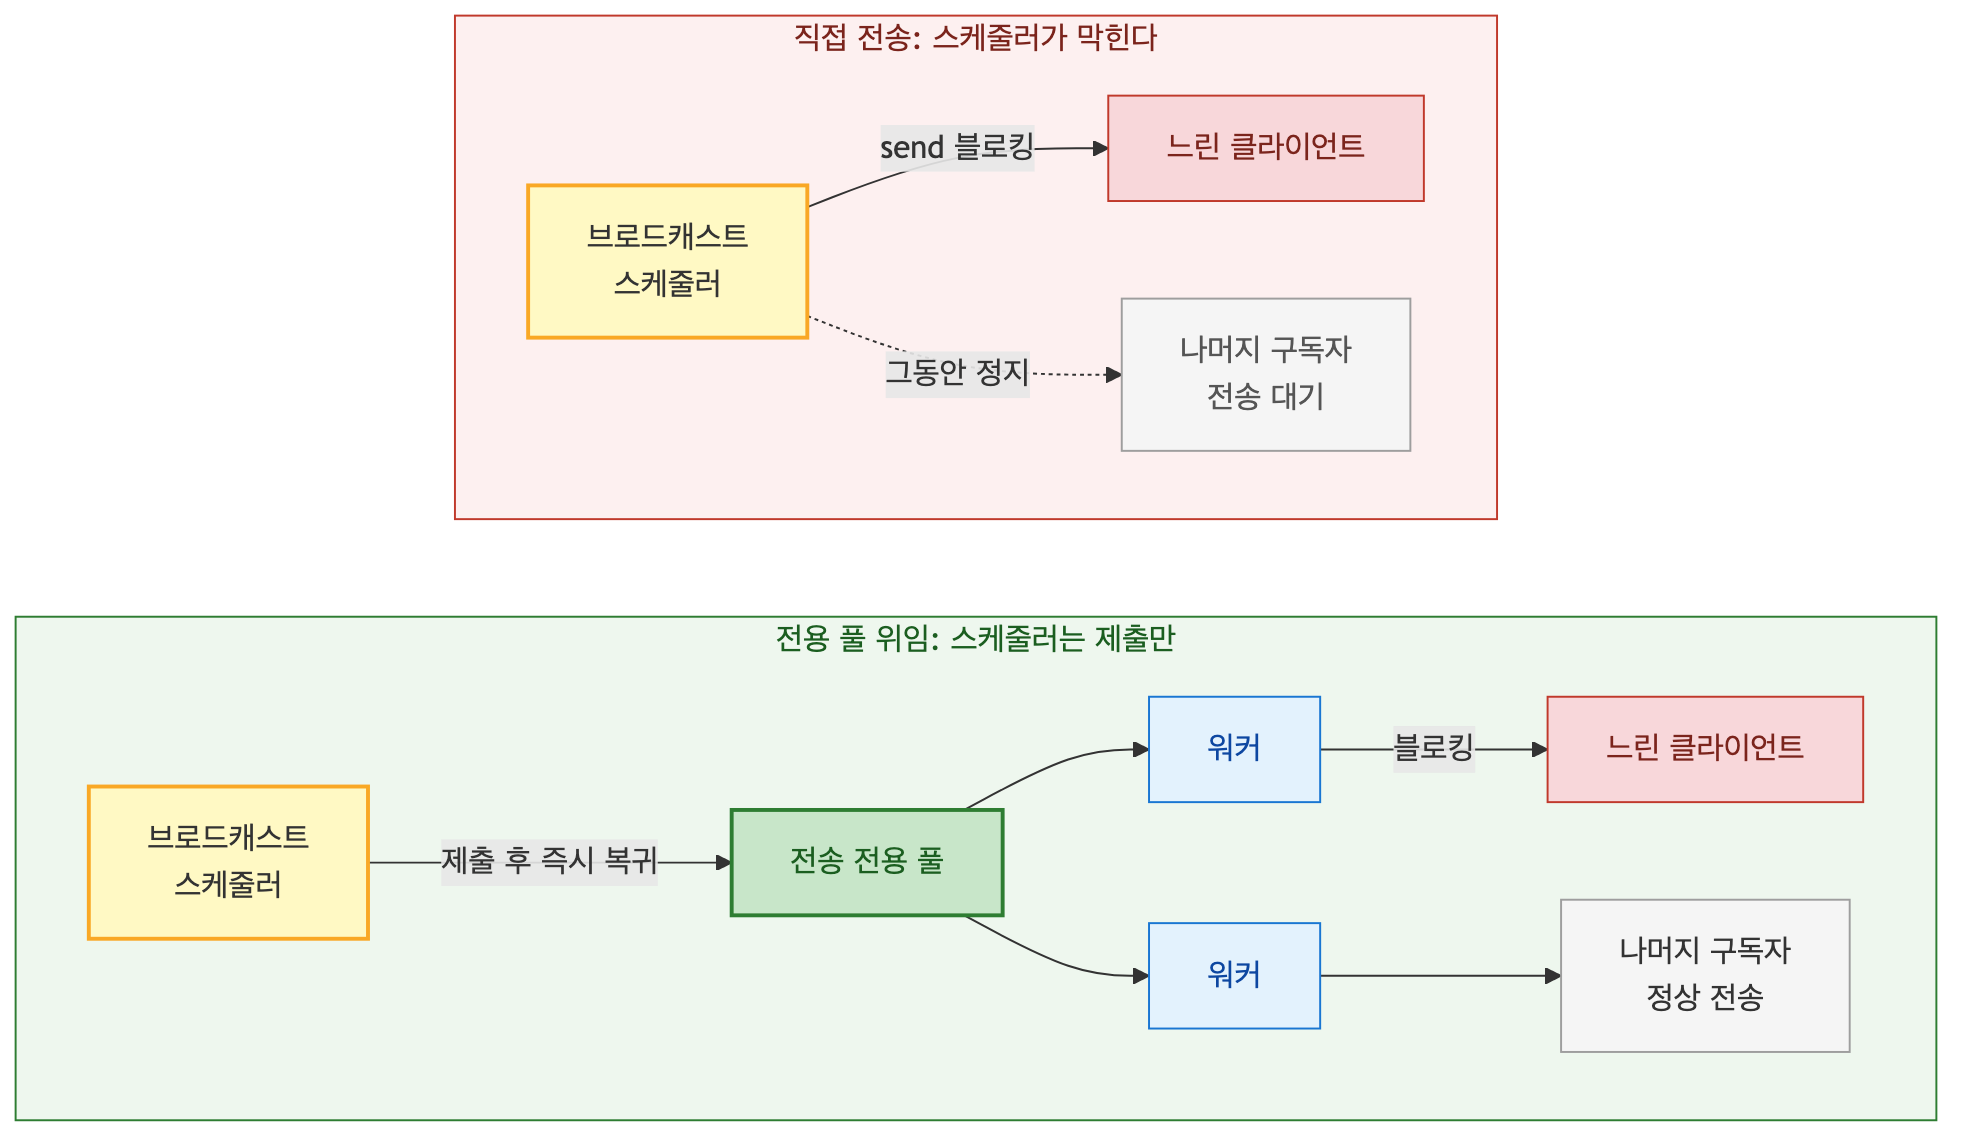
그래서 전송을 전용 스레드 풀에 위임합니다. 스케줄러 스레드는 각 전송을 풀에 제출만 하고 즉시 다음 일로 넘어갑니다. 느린 클라이언트는 워커 스레드 하나만 붙잡을 뿐, 다른 구독자와 스케줄러는 영향받지 않습니다.
for (SseEmitter emitter : emitters) {
    pushExecutor.execute(() -> sendTo(emitter, json));   // 제출만 하고 빠진다
}
풀에는 상한이 있으니 포화될 수 있습니다. 큐가 가득 차 RejectedExecutionException이 나면 그 전송은 버립니다. 다음 주기에 최신 데이터로 다시 나가므로 안전합니다. 오래된 스냅샷을 굳이 밀어 넣을 이유가 없습니다.
전송 실패를 다루는 등급도 정리해야 했습니다. 클라이언트가 탭을 닫으면 broken pipe가 납니다. 이건 오류가 아니라 SSE에서 늘 일어나는 정상 이탈이라 낮은 등급으로 남기고, 그 밖의 예외만 경고로 올립니다. 그리고 전송에 실패하면 레지스트리에서 제거하고 complete()까지 호출합니다. 제거만 하면 비동기 요청이 emitter 타임아웃(최대 1시간)까지 잔류합니다.
3. 병렬 전송이 순서를 뒤집는다
전송을 풀에 위임하자 새 문제가 생겼습니다. 이제 전송이 여러 워커 스레드에서 병렬로 일어나므로, 제출한 순서와 실제 도착 순서가 어긋납니다. 5번 스냅샷을 든 워커가 6번을 든 워커보다 늦게 소켓에 도달하면, 클라이언트는 6번을 받은 뒤 5번을 받습니다.
여기서 이 화면의 특성이 문제를 키웁니다. 페이로드가 변경분(델타)이 아니라 매번 전체 스냅샷입니다. 순서가 뒤집히면 화면이 과거 상태로 되돌아갑니다. 방금 사라진 항목이 다시 나타나는 식입니다.
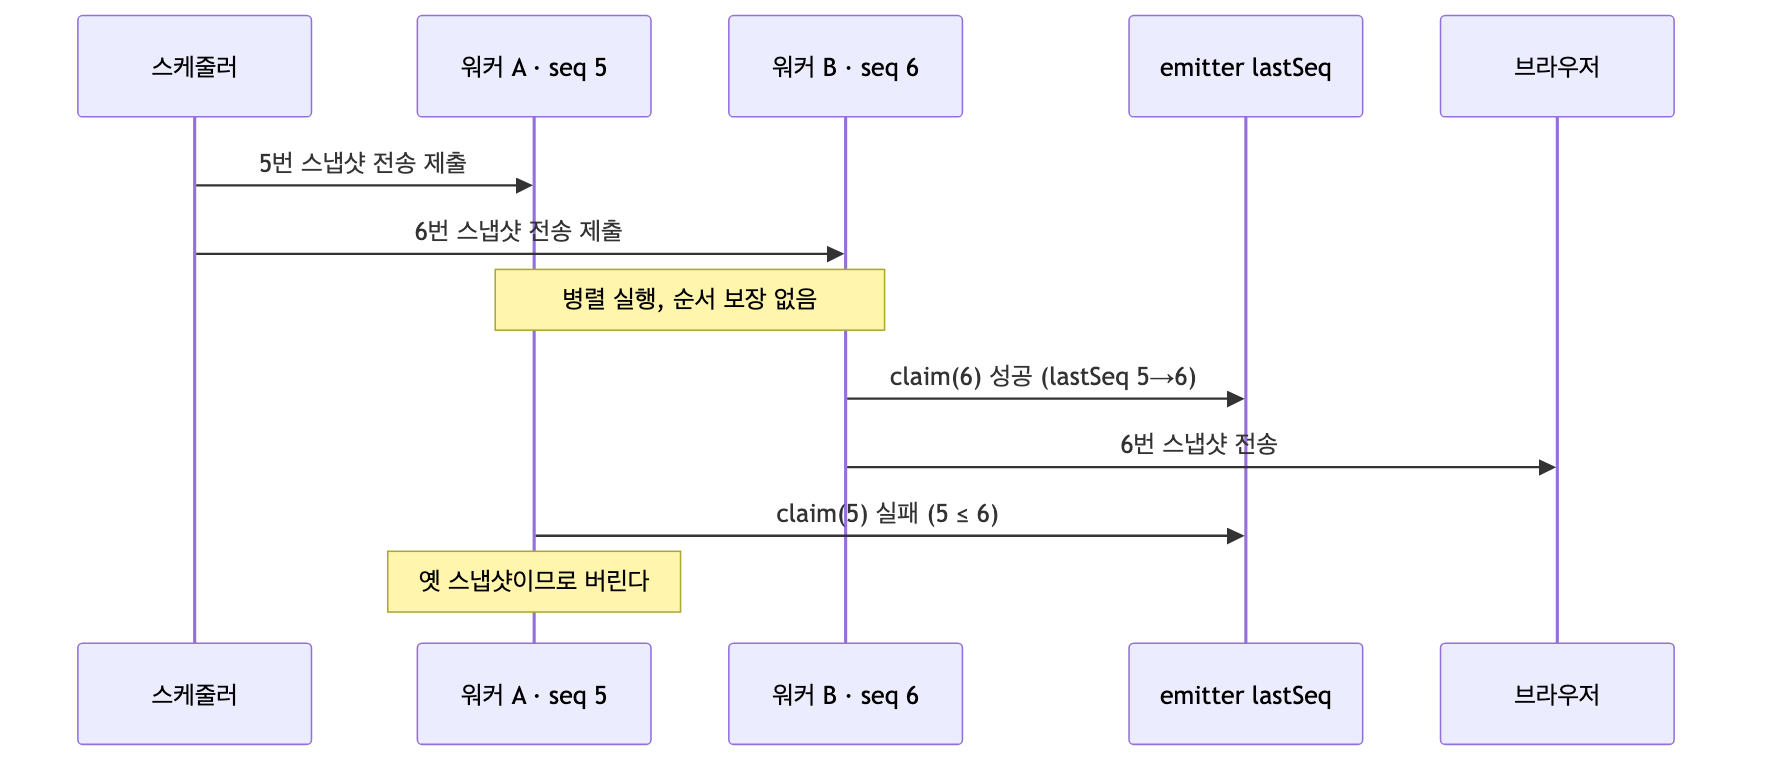
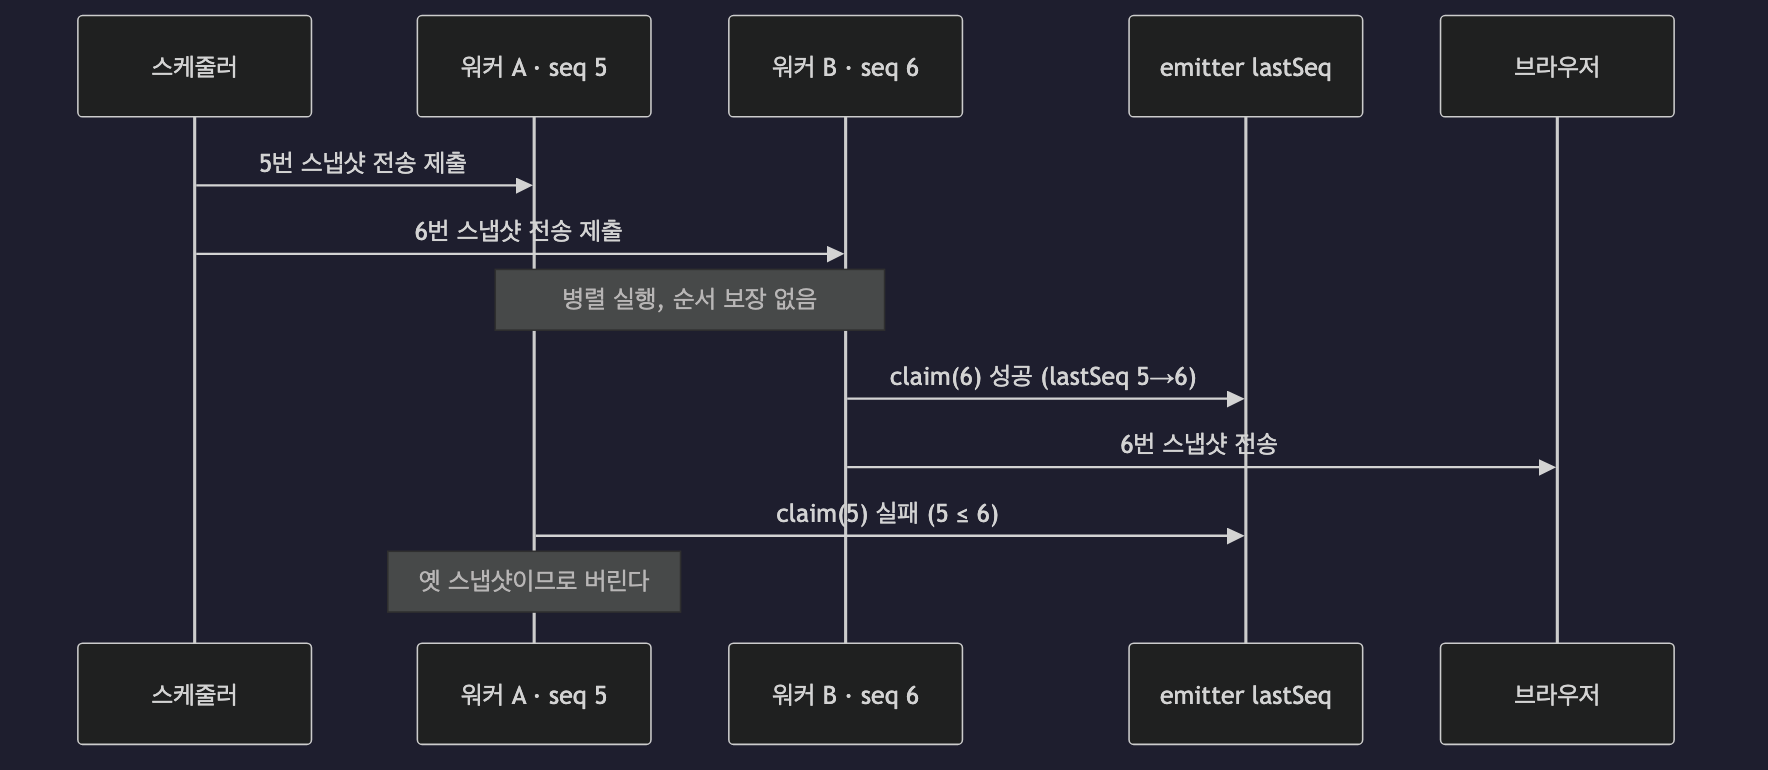
대응은 시퀀스 + CAS 가드입니다. 브로드캐스트 한 번마다 증가하는 번호를 부여하고, emitter마다 "마지막으로 내보낸 시퀀스"를 들고 있다가, 전송 직전에 CAS로 그 자리를 확보합니다. 더 최신 번호가 이미 나갔으면 지금 전송은 버립니다.
boolean claimSequence(long seq) {
    long current;
    do {
        current = lastSentSeq.get();
        if (seq <= current) return false;   // 더 최신이 이미 나감 → 버린다
    } while (!lastSentSeq.compareAndSet(current, seq));
    return true;
}
세부 세 가지를 맞춰야 실제로 동작했습니다.
- 직렬화를 claim 이전에 끝냅니다. claim과 send 사이의 역전 창을 최소화하기 위해서입니다.
- 초기 전송도 같은 가드에 넣습니다. 구독 시점의 시퀀스를
기준값 - 1로 두면, 레지스트리에 막 등록된 직후 더 최신 브로드캐스트가 먼저 나갈 경우 뒤늦은 초기 전송이 claim에 실패해 자연히 버려집니다. - 하트비트는 순서 검사에서 제외합니다. 연결 유지용 주석 프레임은 화면 데이터가 아닌데, 이게 시퀀스를 소비하면 뒤이은 실제 스냅샷이 억울하게 버려집니다.
4. 종료가 전송에 막힌다
세션이 만료되거나 로그아웃하면 그 사용자의 스트림을 닫아야 합니다. 그런데 SseEmitter.complete()는 send()와 같은 내부 쓰기 락을 잡습니다. 느린 클라이언트에게 블로킹 쓰기 중인 워커가 그 락을 쥐고 있으면, 동기로 호출한 complete()는 쓰기 타임아웃까지 줄을 섭니다.
문제는 종료를 호출하는 주체입니다. 세션 소멸은 서블릿 컨테이너의 세션 만료 처리 스레드나 로그아웃 요청 스레드에서 불립니다. 이 스레드를 붙잡으면 컨테이너의 세션 만료 처리 전체가 정체됩니다. 한 사용자의 느린 소켓이 다른 사용자들의 세션 정리를 막습니다.
그래서 종료도 풀에 위임하되, 전송 풀이 아닌 별도의 종료 전용 풀을 씁니다. 전송 풀은 느린 클라이언트로 포화되는 바로 그 풀이라, 전송이 밀리는 순간 종료까지 거부되면 emitter가 타임아웃까지 남습니다.
여기서 중요한 건 "밀어 보내기를 멈춘다"의 보장 시점입니다. 그건 complete()가 아니라 레지스트리에서 제거하는 시점입니다. 제거는 논블로킹이고, 이 순간 이후로는 만료된 세션에 낡은 권한으로 데이터가 나가지 않습니다. complete()는 그 뒤에 별도 풀에서 느긋하게 처리됩니다.
정리 로직은 멱등해야 합니다. complete()는 onCompletion 콜백을 통해 제거 로직으로 다시 들어올 수 있습니다. 레지스트리에서 먼저 제거한 뒤 종료를 제출하면, 재진입 여부와 무관하게 결과가 같습니다.
초기 전송이 실패했을 때 completeWithError()가 아니라 complete()를 써야 했습니다. 전자는 비동기 에러 디스패치를 유발하는데, 예외 핸들러가 JSON 본문을 쓰려는 순간 응답의 Content-Type이 이미 text/event-stream으로 고정돼 있어 직렬화 예외가 터집니다. 스트림 종료만으로도 EventSource는 재연결하므로 complete()로 충분합니다.
한 가지 더. 컨트롤러에서 HttpSession을 주입받는 건 진입 시점이 아직 동기 요청 스레드라 안전합니다. 하지만 반환 직후 비동기 디스패치로 넘어가므로, 그 뒤 서비스 계층에서는 요청 컨텍스트에 접근하면 안 됩니다.
5. 사용자가 보고 있는데 세션이 만료된다
1편 끝에서 잠깐 언급한 문제입니다. SSE는 최초 한 번만 HTTP 요청을 보내고 스트림을 열어 둡니다. 서버가 밀어 보내는 데이터는 새 요청이 아닙니다. 그래서 화면이 1초마다 갱신되고 사용자가 계속 보고 있어도, 서블릿 컨테이너 입장에서 그 세션은 완전히 유휴 상태입니다. 설정된 세션 시간이 지나면 사용자가 화면을 보는 도중에 세션이 조용히 만료됩니다.
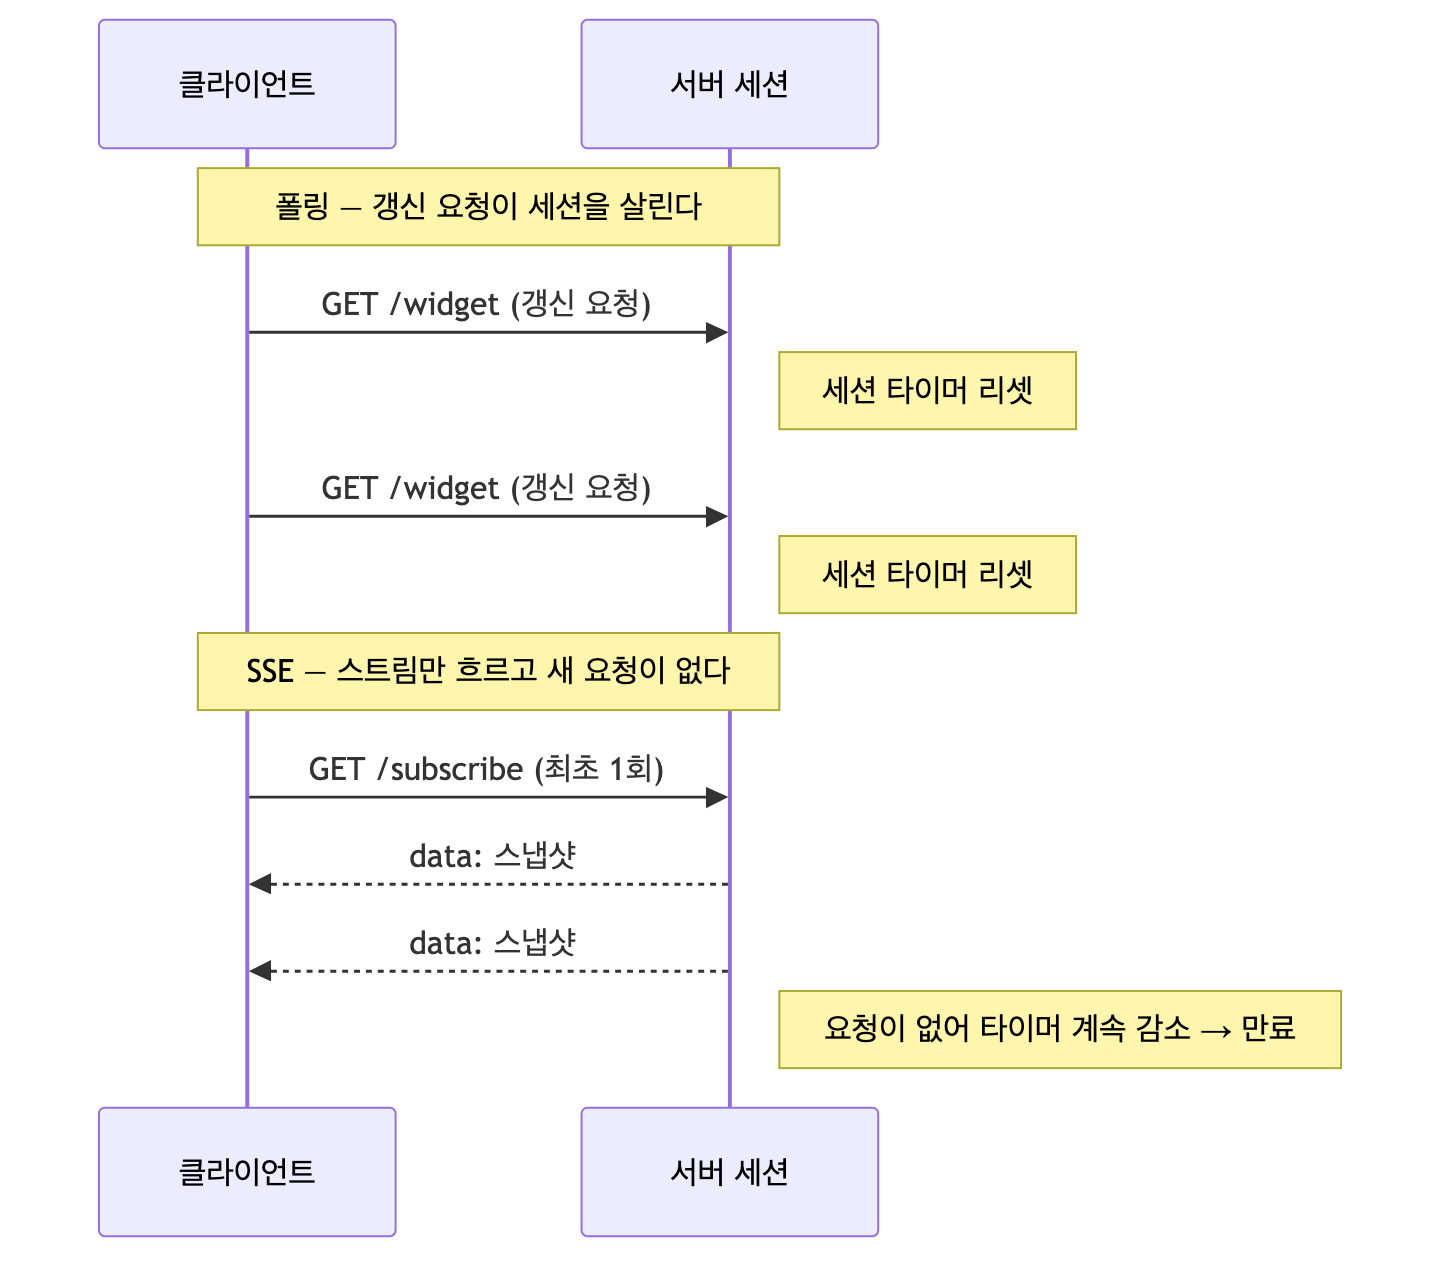
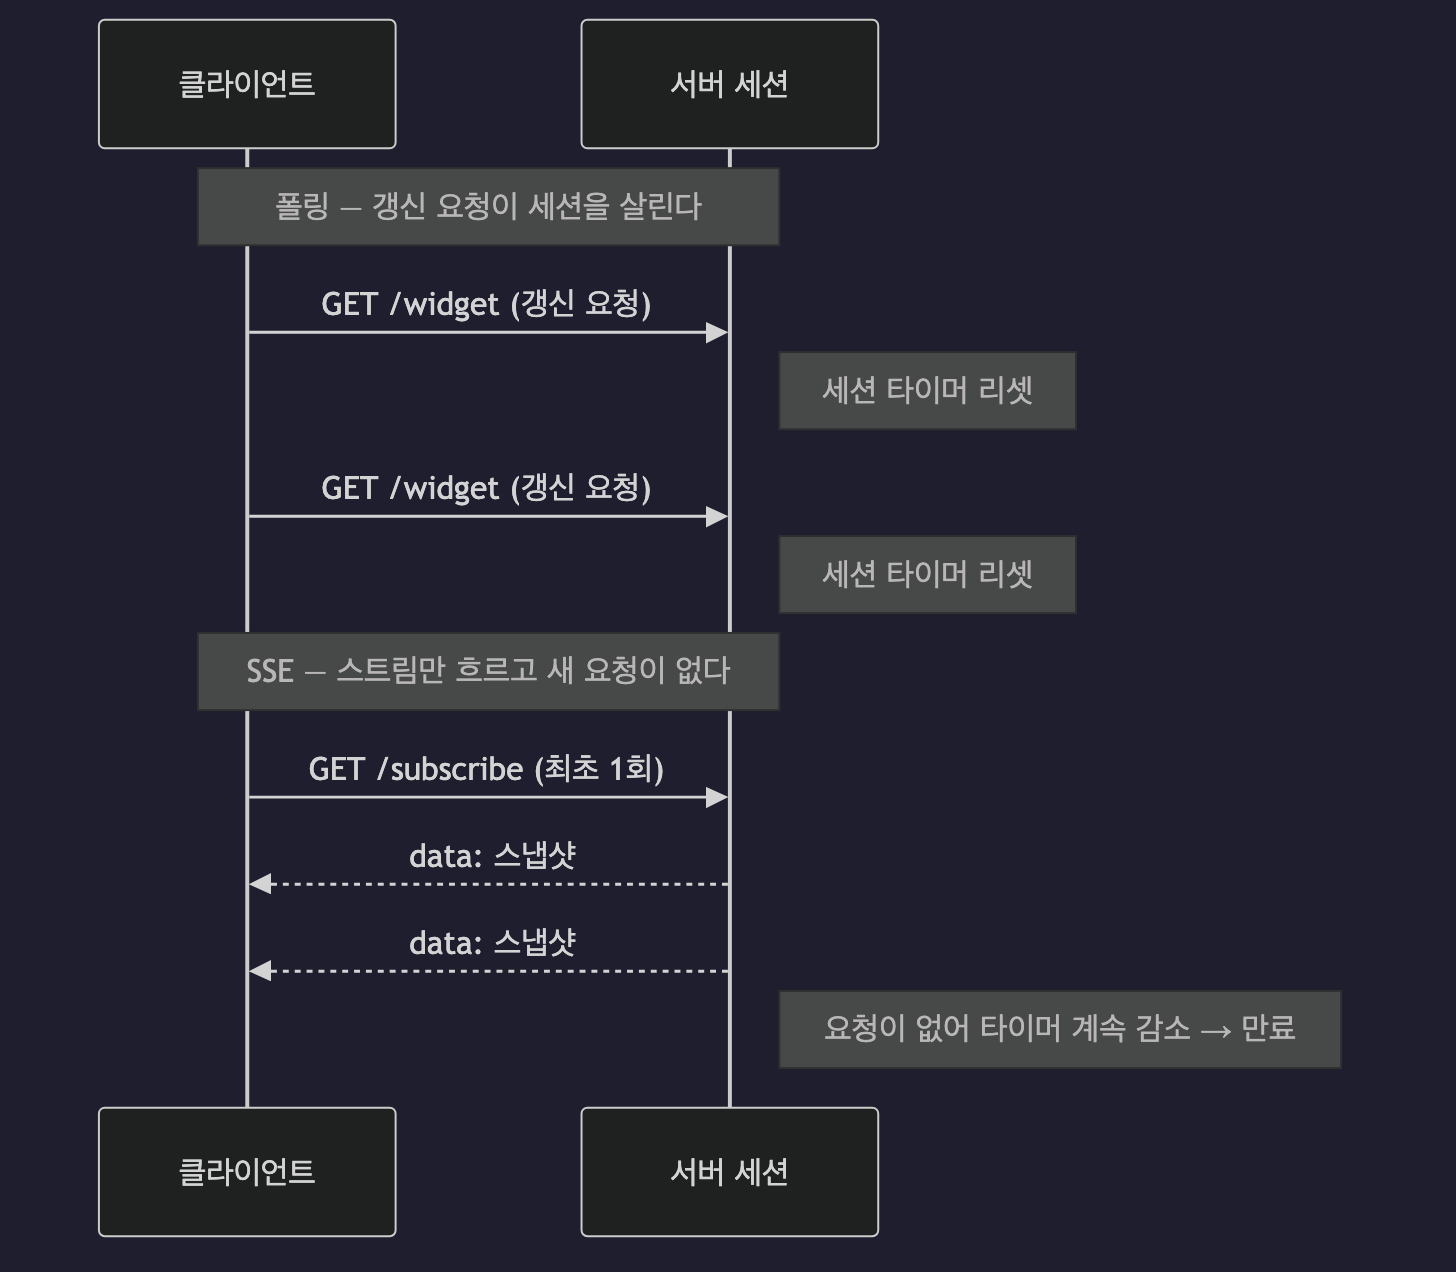
대응은 주기적으로 실제 HTTP 요청(핑)을 한 번씩 보내 세션을 살려 두는 것입니다. 주기는 세션 시간의 절반, 하한 30초입니다. 주기가 관리자 설정에 따라 달라지므로 setInterval이 아니라 재귀 setTimeout으로 매번 다시 계산합니다.
async function scheduleNextPing() {
    const minutes = await getSessionTimeout();
    const intervalMs = Math.max(30000, (minutes * 60000) / 2);
    setTimeout(() => {
        sendSessionPing();
        scheduleNextPing();
    }, intervalMs);
}
간단해 보이지만, 구현하며 걸린 지점이 몇 있었습니다.
- 핑은 POST여야 합니다. 이 앱의 세션 만료 감지가 CSRF 검사에 얹혀 있고 CSRF는 POST 계열만 검증합니다. GET으로 보내면 만료 시 HTML 에러 페이지가 내려가 클라이언트가 만료를 인지하지 못합니다.
- 핑에 개별 에러 콜백을 달면 안 됩니다. 전역 AJAX 에러 핸들러를 덮어써 세션 만료 처리가 사라집니다. 응답 타입도 명시해, 에러가 다른 형식으로 내려와도 전역 핸들러의 분기가 동작하게 해야 합니다.
- 진행 중인 핑을 중단하지 않습니다. 중단도 전역 에러 핸들러를 타는데 엉뚱한 알림이 뜹니다. 후속 스케줄만 취소합니다.
그리고 시작이 비동기라, 탭을 빠르게 전환하면 중단시킨 뒤에 이전 await이 늦게 완료되어 타이머가 되살아납니다. 세대 토큰을 두어, 시작할 때 번호를 올리고 콜백에서 자기 번호가 최신일 때만 실행하게 해 좀비 타이머를 폐기했습니다. 흥미롭게도 이건 멀티탭 세션 동기화에서 다룬 문제의 정반대입니다. 그쪽에서는 백그라운드 폴링이 세션을 계속 살려 유휴 만료가 트리거되지 않는 게 문제였습니다.
6. 재연결이 서버를 다시 무너뜨린다
EventSource는 연결이 끊기면 자동으로 재연결합니다. 편리하지만, 서버가 잠깐 죽었다 살아나면 전 클라이언트가 거의 동시에 재연결을 시도합니다. 막 일어선 서버가 그 순간 다시 쓰러질 수 있습니다.
그래서 재연결을 직접 통제했습니다.
- 지수 백오프에 무작위 지연(jitter)을 섞습니다. 3초, 6초, 12초로 늘려 300초에서 멈추고, 매번 0~1초를 무작위로 더해 재연결 시점을 흩뜨립니다. 다수가 같은 순간에 몰리지 않게 하는 게 핵심입니다.
- 정상 수신을 복구 신호로 삼아 백오프를 리셋합니다. 타임아웃 뒤의 정상 재연결도 항상 3초부터 다시 시작합니다.
- 탭이 보이지 않으면 재연결하지 않습니다. 다른 탭을 보고 있는데 재연결하면 백그라운드에 좀비
EventSource가 쌓입니다. 탭이 다시 보일 때 연결합니다. - 예약된 재연결 타이머의 중복과 잔존을 막습니다. 연결을 끊을 때 예약돼 있던 타이머도 반드시 정리합니다. 안 그러면 탭을 떠난 뒤 뒤늦게 발화해 좀비 연결을 만듭니다.
onerror가 났을 때는 세션 핑을 한 번 보내 "세션이 죽어서 끊긴 건지"를 판별합니다. 세션이 죽었다면 전역 핸들러가 만료 페이지로 보내며 이 재연결 루프도 함께 끝납니다. 다만 서버가 완전히 다운된 동안에는 재시도마다 실패 핑이 알림을 반복 노출하지 않도록 30초 간격으로 눌렀습니다.
7. 권한을 회수했는데 화면에 남아 있다
마지막 문제는 앞의 최적화가 정확성과 충돌한 지점이라, 이 글의 매듭이 됩니다.
구독 중에도 사용자 권한이 바뀔 수 있어서, 주기적으로 각 구독자의 허용 자원 목록을 다시 조회합니다. 이때 구독자마다 개별 쿼리를 날리면 이 갱신 한 번이 스레드를 오래 붙잡아 브로드캐스트를 지연시킵니다. 그래서 서로 다른 사용자 ID를 모아 한 번의 배치 쿼리로 가져옵니다.
핵심 함정은 여기 있습니다. 권한이 회수됐는데 파이프라인 데이터가 그대로면, 섹션 1의 dedup 때문에 다음 브로드캐스트가 생략됩니다. 그 결과 회수된 자원의 행이 화면에 그대로 남습니다. 최적화가 정확성을 깨뜨린 것입니다.
풀이는 단순합니다. 권한에 변경이 감지되면 dedup 기준을 무효화해 재전송을 강제합니다. 데이터가 같아도 권한이 바뀌었으면 반드시 다시 내보냅니다.
if (permissionsChanged) {
    lastJson.set("");   // dedup 기준을 비워 다음 브로드캐스트를 강제한다
}
실패 정책도 정해야 했습니다. 배치 쿼리가 일시적으로 실패하면 이번 주기의 기존 스냅샷을 유지합니다. DB 오류로 대시보드가 통째로 비는 것보다 가용성을 택한 것이고, 회수는 다음 갱신 주기에 반영됩니다. 다만 이건 트레이드오프입니다. 회수 반영이 한 주기 늦어도 되는 환경에서만 성립합니다. 조회 결과에 없는 사용자는 "조회 실패"가 아니라 "접근 가능 자원 0건"으로 해석하고, 진짜 실패는 따로 구분해 호출자가 판단하게 했습니다.
마치며
SseEmitter를 반환하는 30줄과, 그 화면을 운영에 올리는 코드 사이의 간극을 순서대로 정리하면 이렇습니다.
- 부하: 구독자가 없으면 조회하지 않고, 직전과 같으면 보내지 않고, 한산하면 주기를 늦춥니다.
- 격리:
send()는 블로킹이므로 전송을 전용 풀로 빼서 느린 클라이언트가 전체를 막지 못하게 합니다. - 순서: 전체 스냅샷을 병렬 전송하면 역전이 생깁니다. 시퀀스 + CAS로 옛 전송을 버립니다.
- 종료:
complete()는 전송과 락을 다툽니다. 종료 전용 풀로 분리하고, 밀어 보내기 중단은 레지스트리 제거로 보장합니다. - 세션: 스트림은 세션을 살리지 못합니다. 주기적 핑으로 세션을 유지합니다.
- 재연결: 자동 재연결은 동시에 몰립니다. 백오프와 jitter, 탭 가시성으로 통제합니다.
- 정확성: dedup 최적화가 권한 회수 반영을 막습니다. 권한이 바뀌면 dedup을 무효화합니다.
이 목록에서 뒤의 절반은 앞의 절반이 만든 문제였습니다. 전용 풀로 전송을 격리하자 순서 역전이 생겼고, 조회를 아끼려 넣은 dedup이 권한 회수를 막았습니다. 최적화 하나가 다른 요구를 깨뜨리는 지점을 어떻게 풀지가, 결국 "동작하는 코드"와 "운영에 올릴 수 있는 코드"를 가르는 부분이었습니다.
참고
- SseEmitter↑
- 컨트롤러가 `SseEmitter`를 반환하면 서블릿 요청은 비동기 모드로 전환되고 응답은 열린 채 유지됩니다. 이후 다른 스레드에서 `emitter.send()`로 이벤트를 밀어 넣고, `complete()`로 스트림을 닫습니다. `onCompletion`·`onTimeout`·`onError` 콜백으로 정리 시점을 잡습니다.
- 블로킹 쓰기↑
- `emitter.send()`는 소켓 버퍼가 빌 때까지 기다리는 블로킹 연산입니다. 수신이 느린 클라이언트에게 쓰면 그 시간만큼 호출 스레드가 점유됩니다. 브로드캐스트 스케줄러 스레드에서 직접 호출하면 느린 클라이언트 한 명이 전체 전송을 지연시킵니다.
- CAS↑
- Compare-And-Swap의 약자입니다. 현재 값이 예상한 값과 같을 때만 새 값으로 교체하고, 다르면 실패를 반환합니다. 락 없이 여러 스레드가 하나의 값을 안전하게 갱신할 때 씁니다. Java에서는 `AtomicLong.compareAndSet` 등으로 제공됩니다.
- broken pipe↑
- 클라이언트가 탭을 닫거나 네트워크가 끊긴 뒤 서버가 그 연결에 데이터를 쓰려 하면 발생합니다. SSE에서는 클라이언트가 수시로 떠나므로 정상적으로 자주 나는 오류입니다. 그래서 에러가 아니라 낮은 로그 등급으로 다뤄야 로그가 오염되지 않습니다.
- 서블릿 비동기 디스패치↑
- `SseEmitter`를 반환하면 요청은 서블릿 비동기 모드로 들어갑니다. 컨트롤러 진입 시점은 아직 요청 스레드라 `HttpSession` 같은 요청 컨텍스트에 접근할 수 있지만, 반환 직후부터는 다른 스레드가 스트림을 다루므로 서비스 계층에서 요청 스코프에 접근하면 안 됩니다.
- 멱등↑
- 같은 연산을 두 번, 세 번 반복해도 상태가 한 번 실행한 것과 동일하게 유지되면 멱등하다고 합니다. 정리 로직이 콜백으로 재진입할 수 있는 SSE에서는, 레지스트리 제거 같은 정리를 멱등하게 만들어 두어야 중복 호출이 문제를 일으키지 않습니다.